两轮前端设计实验:我让 GPT、Gemini、Claude、Kimi、Grok、GLM、MiniMax 各自做网页,AI 真的有稳定审美吗?
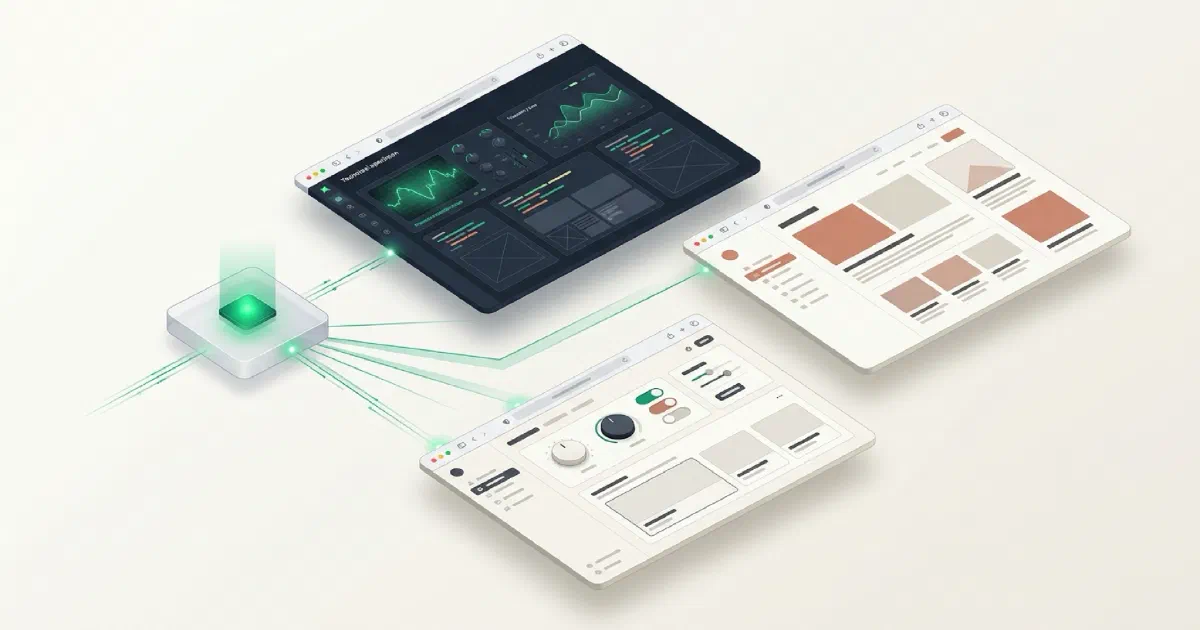
两轮测试后的结论:AI 前端并没有收敛成同一种审美。不同模型 / Harness 在低约束设计任务中反复暴露出明显不同的设计偏好:OpenAI 更擅长实体空间与成熟商业品牌,Gemini 偏概念与互动实验,Claude Sonnet 更像产品 / 品牌设计师,Kimi 擅长中文 typography 与 editorial,Grok 偏电影与舞台感。与其寻找一个「审美最强」的模型,不如利用这些稳定偏差组成一个多模型设计竞标池。
如果你经常用 AI 生成前端,大概率对这个场景不陌生:十个 AI 做的网页,八个长得差不多——大标题、圆角卡片、紫蓝渐变、玻璃拟态、三列功能区。我一直在想:为什么 AI 做出来的前端越来越像?有没有办法让不同模型真正给出不同的设计方向?
这篇文章记录了两轮测试。第一轮用「一个独立开发者的 AI 造物档案」做主题,观察各模型自己的设计 prior;第二轮换成完全不同的题材「一家只在雨天营业的深夜甜品店」,把模型赶出 AI / 开发者审美舒适区,Claude 也在这一轮加入。两轮之后,每个模型家族稳定的设计人格已经相当清楚。
为什么换掉原来的工作流
过去我的流程是:ChatGPT 先出设计图,再让 GPT / Kimi / 其他 Coding Agent 照图实现。问题很明显——最终页面很容易落回同一种 AI 风格。
这次我改了玩法:直接让模型自己承担 Art Director + Frontend Developer 的角色。不给明确视觉风格,只规定主题、内容结构和禁止项,要求 one-shot 交付完整 HTML,以此观察模型自己的设计 prior。
测试方法与边界
- 两轮使用各自的同一 Prompt,不同模型跑同一条题。
- 只允许生成一个可直接运行的完整 HTML;CSS / JS 内联。
- 不依赖图片素材,需要图形时自行用 CSS / SVG / Canvas 创作。
- 同时观察桌面端与 390px 左右移动端。
- 重点不是代码 benchmark,而是:Art Direction、视觉差异化、排版、配色、原创图形、交互、成品感、响应式。
- Harness 与模型没有完全解耦,因此这不是纯模型 benchmark。除 Pi 内部 High / Max 外,大部分结果只能解释成「模型 × Harness」的组合表现。
- 第一轮 Gemini 3.8 Flash 因工作目录异常,结果作废。随后分别在 Antigravity CLI 与 Antigravity IDE 重新生成,两份新结果纳入最终比较。
第一轮的原始测试 Prompt
请设计并实现一个完整的单页 HTML 网站,主题是:
「一个独立开发者的 AI 造物档案」
这个人平时会用 AI 做小游戏、工具、实验性项目和一些奇怪但有趣的东西。网站用于展示他最近做出来的作品,而不是卖课或宣传公司。
页面需要包含:一个有记忆点的首屏;当前正在折腾的项目;4~6 个已经完成的作品;最近的实验 / 更新记录;一个简单但有个性的 About。
请你自己决定整体视觉方向、排版、字体、色彩、留白、组件形式和交互方式。我不想指定具体设计风格,我想看你的设计判断。
但请避免典型 AI / SaaS 模板感:不要默认紫蓝渐变;不要满屏玻璃拟态;不要所有内容都塞进大圆角卡片;不要千篇一律的「巨大标题 + 三张功能卡片 + CTA」;不要用 Emoji 充当主要图标。
希望它看起来像一个真正有审美的独立设计师 / 开发者认真设计过的个人网站,有明显的视觉个性和细节,但不要为了炫技牺牲可读性。可以加入克制的 hover、滚动、微动效和有趣的小细节。
要求:只输出一个可以直接打开运行的完整 HTML 文件;CSS 和 JavaScript 全部包含在 HTML 内;桌面和手机都要适配;不依赖图片素材;页面里的中文文案也请你自己写;不要先解释设计方案,直接完成成品。
请把它当成一个真正会放进你自己作品集的项目来设计,而不是前端能力演示。
第一轮:11 个有效样本
| 组合 | 主要设计人格 | 本轮观察 |
|---|---|---|
| Pi · GPT-6 Max | 成熟独立 Maker / 产品杂志 | 复古电台主视觉、定制 SVG / 插画、品牌统一度最高的一批 |
| Pi · GPT-5.6 Sol High | 温暖 editorial + 手绘实验室 | 首屏文案、橙红 + 草绿、手绘物件的完整度很高 |
| Gemini 3.8 Flash · Antigravity IDE | Tactical Editorial / Hardware Field Notes / Ink & Phosphor | 桌面端第一梯队;Canvas、实验台、schematic、热敏纸等交互与世界观高度统一;移动端导航有溢出 |
| Claude Code · MiniMax M3 | 实验杂志 / Brutalist graphic design | 最敢设计、最不模板化;大字号、不对称、巨型几何图很有辨识度 |
| Grok · 4.6 XHigh | 档案封面 / cinematic art direction | 黑色档案封面转米白正文,概念叙事强 |
| Pi · GPT-6 High | 柔和 Indie Maker | 想法机器 + 多组定制视觉,稳定好看 |
| Gemini 3.8 Flash · Antigravity CLI | 冷峻数字标本馆 | 比 IDE 更克制,炭黑 + 骨白 + 朱砂橘;headline 与档案气质很强 |
| Pi · GPT-5.6 Sol Max | Acid-lime 独立设计工作室 | 完成度高,但绿色设计系统更接近近年的流行设计语言 |
| Claude Code · K3-256 | 中文 editorial / 纸质档案 | 排版纪律强,极简、红章、黑色实验区稳定;原创视觉素材较少 |
| Kimi Web · K2.6 进阶 | 中文个人手账 / 档案册 | 文字和 typography 很有人味,知道什么时候停;视觉复杂度不高但有 taste |
| ZCode · GLM-5.3 Flash | 技术 Specimen / 档案馆 | 完成度高、响应式稳,但视觉语言和 Kimi / K3 的档案方向有重叠,独占性较弱 |
最值得保留的几个结论
Gemini 3.8 Flash 必须重新评价
异常环境下的旧结果不能代表 Gemini。正常重测后,Antigravity IDE 与 CLI 两份都进入强势区间。
两份独立输出存在明显共同的「模型指纹」:炭黑 / 工业橙红 / mono telemetry / specimen / archive / Canvas 实验装置 / 独立造物工坊。Harness 改变的是展开程度:IDE 更像完整数字实验室,CLI 更像克制的数字标本馆。
所以 Gemini 3.8 Flash 的前端定位上调为:第一梯队的实验型 Art Director / Prototyper。尤其适合实验站、Lab、Canvas、技术艺术、深色编辑风。
GPT 不是「没有审美」,而是普通工作流容易回到安全 prior
Pi + GPT-6 / Sol 的几份结果说明:当 Prompt 明确要求远离 SaaS 模板、让模型自行承担 Art Direction 时,GPT 完全可以做出成熟、有品牌感甚至有原创插画系统的成品。
GPT/Pi 最突出的不是「界面更复杂」,而是更擅长创造有实体记忆点的东西:收音机、旋钮、手绘物件、小型装置,而不是只创造一个系统界面。
MiniMax M3 的价值是「胆子」
M3 不一定是完成度最高,但它最敢突破安全布局。超大字号、非对称、brutalist typography、巨型机械图,让它成为很好的 design exploration 模型。
如果目标是避免 AI 同质化,M3 很适合被要求一次给出极端不同的方向。
Kimi 49 的前端价值已经够用,不构成升级 99 / K3 的硬理由
K2.6 Web 已经能给出有味道的中文 editorial 方向;K3 更成熟、更克制,但没有形成压倒性的审美差距。
结合此前博客盲测:K2.8 的中文自然感 / 低 AI 味已经是 Kimi 49 的真实独特价值;K2.6 Web 又可作为低成本设计脑暴。 因而现阶段没有因为「前端审美」升级 Kimi 99 的必要。
GLM 很强,但对当前订阅体系仍属可替代能力
GLM-5.3 Flash 此前在长上下文审计任务中表现优秀,这轮前端也做得完整;但无论 Agent / Auditor 还是前端,现有 GPT / Codex 都可以承担。预算有限时,GLM 的边际价值低于 Kimi 的中文 taste,因此暂不因为这轮测试新增 GLM 订阅。
Harness 对设计输出的影响
这轮不能把结果简单解释成纯模型排名,因为大多数模型绑定了不同 Harness。目前能看到的现象:
- Pi 下 GPT-6 / Sol 四份结果共享「暖色、独立 Maker、定制图形」的家族感,说明 Harness 很可能会塑造输出。
- Gemini CLI / IDE 同时保留相同的暗色实验设计指纹,但 IDE 更复杂、更交互化。
- 思考强度并非审美单调递增:GPT-6 Max 比 High 更统一,但 Sol 反而 High 的生命力更好。
因此以后做审美 benchmark,应该把 模型 / Harness / reasoning level 三个变量分别记录。
响应式:桌面强不等于移动端稳
Gemini IDE 桌面端很强,但 390px 实测存在导航横向溢出;CLI 没有真实横向 overflow,但顶栏仍偏拥挤。相比之下,K3、Pi GPT 与 GLM 的移动端收尾相对稳定。
这说明一个值得长期记录的现象:桌面 Art Direction 强,不等于响应式工程收尾同样强。 以后评分需要把 desktop taste 和 mobile implementation 分开。
第一轮之后的订阅决策落点
- Gemini 3.8 Flash:设计竞标池主力,成本接近可忽略;保留。
- Kimi 49:更适合当前个人体系。K2.8 负责重要中文成稿,K2.6 Web 可负责设计方向探索;继续月付观察,不急年付,不升 99。
- GLM Lite:能力强,但当前 GPT/Codex 足以替代其主要工作;暂不新增年付。
- Grok:前端属于加分项,真正独特价值仍是 X/Twitter + adversarial research;促销期继续,恢复正价后重新竞争预算。
第二轮:雨天深夜甜品店——把模型赶出「AI / 开发者审美舒适区」
第一轮的主题仍然是开发者作品集,模型很容易落入 terminal、grid、telemetry、archive 这些科技设计套路。第二轮我换了一道完全不同的题:「一家只在雨天营业的深夜甜品店」。
目的不是继续测谁会做漂亮 Landing Page,而是强迫模型同时处理:空间感、品牌感、材质、中文文案、真实商业信息、情绪和非技术交互。模型必须回答更具体的问题:雨怎么成为品牌机制?甜品如何被表达?店铺空间如何让人产生「今晚想去坐一会」的感觉?
15 个有效 / 尝试样本
| 顺位 | 模型 / Harness | 耗时 / 额度 | 本轮观察 |
|---|---|---|---|
| 1 | GPT-6 Pro · ChatGPT Web | 19m53s | 最完整的真实品牌官网;店铺空间、插画、信息和情绪融合最好 |
| 2 | GPT-6 Astra · Codex XHigh | 21m20s | 更克制的 OpenAI 方案;空间感和「雨下着。你坐着。」非常强 |
| 3 | Claude Sonnet 4.6 · Antigravity IDE | 12m19s | 品牌系统、产品信息、氛围之间最均衡的一批;真正把「雨天营业」做成产品机制 |
| 4 | Gemini 3.8 Flash · Antigravity IDE | 3m54s | 效率冠军;不到 4 分钟已经进入第一梯队,concept + atmosphere 都很强 |
| 5 | GPT-5.6 Sol · Codex XHigh | 16m55s | 非常成熟、商业落地感强,但与 GPT-6 / Astra 存在明显 OpenAI 家族相似性 |
| 6 | Kimi K3 · Web Max | 月额度 8.97% | 高级 editorial / 大字排版;视觉气质强,但更像品牌画册 |
| 7 | Kimi K2.8 · Web Max | 月额度 3.82% | 「雨下了,灯就亮着。」非常直接;中文、typography 和品牌气质很准 |
| 8 | Grok 4.6 · XHigh | 37m05s | 最 cinematic,像电影场景 / 舞台美术;视觉记忆强但信息表达较少 |
| 9 | Claude Opus 4.6 · Antigravity IDE | 12m38s | 文学型极简 Art Direction;文字、留白、克制非常强,但视觉产出偏少 |
| 10 | GLM-5.3 · ZCode Max | 24m30s | 强排版 + 店铺插画,完成度不错;仍未形成不可替代设计人格 |
| 11 | Kimi K2.6 · Web | 0 Web 额度 | 极高性价比;最大优点是「知道什么时候停」,适合低成本 Art Direction 脑暴 |
| 12 | Gemini 3.1 Pro · Antigravity IDE | 4m | 把「等一场雨」做成进入网站前的交互机制,概念聪明,但真实官网 UX 过度 |
| 13 | Gemini 3.8 Flash · Antigravity CLI | 5m45s | 文学 / 信息设计不错,但视觉表达明显弱于同模型 IDE |
| 14 | GLM-5.3 Flash · ZCode Max | 1h03m | 耗时长,且移动端出现严重横向 overflow |
| DNF | Kimi Code · K2.8 Max | 5h 窗口耗尽 | 未完成;HTML 在 body 之前结束。本轮按 workflow failure 记录,不作为审美失败 |
Claude 加入后,模型人格更清楚了
Claude Sonnet 4.6 更像 Product / Brand Designer:不是只做一个漂亮首屏,而是把今日天气、营业状态、菜单标签、品牌故事、空间 SVG、店规、地图、雨讯订阅和雨声都组织成一个完整系统。它在本题里明显比 Opus 更适合作为常规品牌站设计选手。
Claude Opus 4.6 则更像文学型 Art Director:极窄正文、极少视觉元素、深色背景、长篇店铺叙事和大量留白。它最大的价值不是「组件更多」,而是真的敢不填满页面。在诗集、独立出版社、香水、艺术展、极简个人站等题材里可能更占优势。
同一个 Antigravity IDE 下可以看到非常清楚的分工:
- Gemini 3.8 Flash:效率 / 实验性 / 概念视觉。
- Gemini 3.1 Pro:interaction concept,容易过度设计。
- Claude Sonnet 4.6:系统完整、品牌一致、产品信息组织强。
- Claude Opus 4.6:克制、文学、留白、情绪。
两轮测试后观察到的模型设计人格
需要先说明一点:Claude Sonnet 4.6 与 Opus 4.6 仅参与第二轮,因此它们的人格判断目前仍属于单题观察;其余模型家族则有两轮交叉验证,「稳定」的结论更有依据。
| 模型家族 | 两轮测试后出现的稳定设计人格 |
|---|---|
| OpenAI | 实体空间、原创物件、品牌插画、成熟商业设计;完成度稳定,但同家族容易趋同 |
| Gemini | 概念、互动、实验型 editorial;喜欢先创造机制 / 世界,再设计界面 |
| Claude Sonnet | 产品设计师 / 品牌系统;完整、理性、信息结构好 |
| Claude Opus | 文学型 Art Director;留白、文字、克制、氛围 |
| Kimi | 中文 typography、文案、editorial 气质;靠语言与排版建立品牌人格 |
| Grok | 电影、舞台、海报、场景调度;概念画面感强 |
| GLM | 中文强排版 + 插画式 Landing;完成度不错,但目前人格辨识度相对弱 |
收敛后的固定竞标池:4 个方向
不需要每次把所有模型都跑一遍。更合理的固定竞标池可以缩成 4 个差异最大的方向:
- Gemini 3.8 Flash · Antigravity IDE:快速、近免费、实验性强。
- Claude Sonnet 4.6 · Antigravity IDE:品牌系统 / 产品完成度。
- Kimi K2.6 Web:0 Web 额度的中文 typography / 克制方向。
- GPT-6 / Sol / Codex 中选一个:成熟商业设计、实体空间、原创插画。
特殊题材再临时增加:电影感 → Grok;文学极简 → Opus;需要更浓 Kimi 味 → K2.8。
这比「找一个审美最强模型长期包办 UI」更有效:不同模型的稳定审美偏差,本身就是创意发散工具。
新的前端工作流
同一个低约束设计 Brief
→ Gemini 3.8 Flash / Claude Sonnet / Kimi K2.6 / GPT-Codex 各自 one-shot HTML
→ 特殊题材按需加入 Grok / Opus / MiniMax / K2.8
→ 只选 2~3 个真正不同的 Art Direction
→ 提炼字体、色板、spacing、边框、动效、插画 / 图形哲学
→ 固化为 DESIGN.md / design tokens
→ GPT / Codex 正式工程化实现
→ 最后做 screenshot review + 响应式检查
关键思想:不要让模型先共同收敛到一个设计图,再去实现;先让不同模型各自暴露自己的 prior。 模型之间的差异本身就是廉价的创意发散工具。
Demo 怎么看
每个参赛网页都会以独立 demo 的形式保留,正文里按需嵌入 iframe,滚动、Canvas、声音这些截图表达不了的部分可以直接上手操作;每个 demo 同时提供「新窗口打开完整页面」的链接,方便移动端和 iframe 受限的环境。
下一步
第三轮的计划:给所有模型同一 moodboard / 参考图,测试「吸收参考但不机械抄袭」的能力。这正好补上两轮都没覆盖到的一个变量——前两轮完全不给视觉参考,只测模型自己的 prior;下一轮看模型在既有参照下的消化能力。
KEEP READING